
Google apresenta TPU 8tx com processadores AMD EPYC e TPU 8i Max com dois chips em um único pacote
O Google ampliou sua família de aceleradores de inteligência artificial TPU v8 com dois novos modelos voltados para cargas de trabalho avançadas. A TPU 8tx combina processamento especializado com CPUs AMD EPYC de quinta geração e computação confidencial, enquanto a TPU 8i Max reúne dois chips TPU 8i em um único pacote para dobrar a capacidade computacional e a largura de banda de memória.
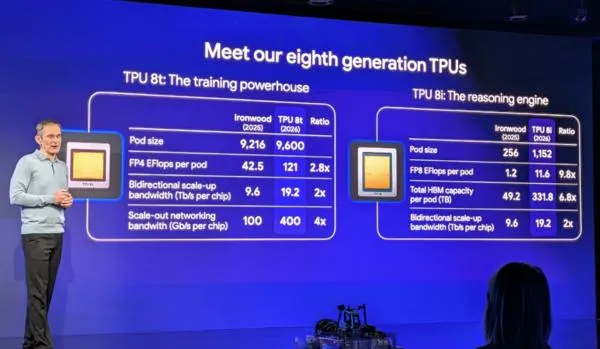
O Google anunciou duas novas configurações de sua oitava geração de aceleradores de inteligência artificial: a TPU 8tx e a TPU 8i Max. As novidades foram desenvolvidas para atender às necessidades crescentes de sistemas de IA capazes de executar tarefas complexas, trabalhar com grandes quantidades de informações e operar agentes autônomos simultaneamente.
O anúncio representa mais um passo na estratégia da empresa para ampliar sua infraestrutura de inteligência artificial e oferecer alternativas especializadas aos tradicionais aceleradores utilizados em data centers. Entre os principais destaques estão a parceria com a AMD na infraestrutura da TPU 8tx e a integração de dois chips TPU 8i na nova versão Max.
TPU 8tx combina processamento de IA com CPUs AMD EPYC
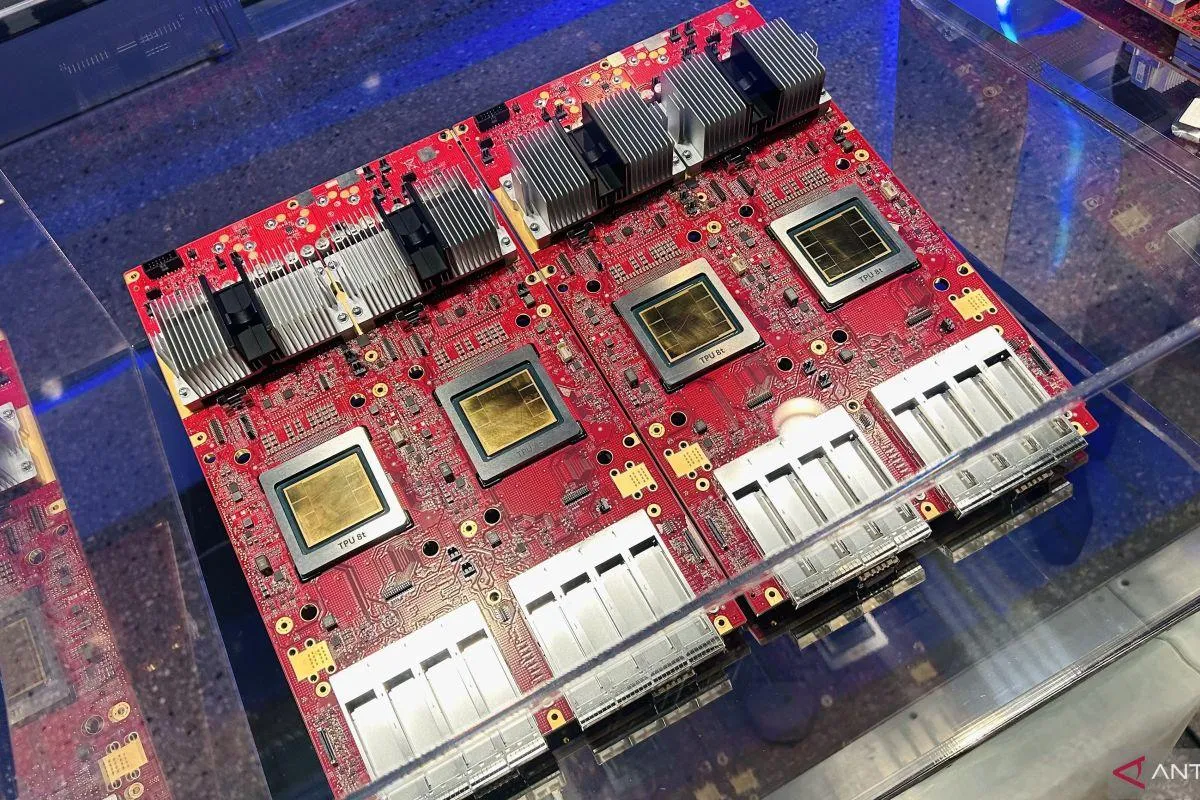
A TPU 8tx foi desenvolvida a partir da arquitetura da TPU 8t, originalmente direcionada ao treinamento de modelos de inteligência artificial em larga escala. Entretanto, a nova configuração recebeu modificações importantes para atender principalmente aplicações de inferência confidencial e treinamento de menor escala.
Uma das mudanças mais relevantes está na utilização de processadores AMD EPYC de quinta geração como CPUs responsáveis pela infraestrutura de hospedagem. A colaboração permite combinar os aceleradores especializados do Google com a capacidade de processamento geral dos servidores AMD.
A principal finalidade dessa integração é oferecer computação confidencial diretamente no nível do hardware. Em sistemas convencionais, informações criptografadas durante o armazenamento e a transmissão precisam ser descriptografadas durante o processamento. Esse momento pode representar um risco para dados empresariais e modelos proprietários.
Com a TPU 8tx, o Google pretende manter informações sensíveis e pesos dos modelos protegidos mesmo durante sua utilização, atendendo especialmente empresas e organizações governamentais que trabalham com dados restritos.
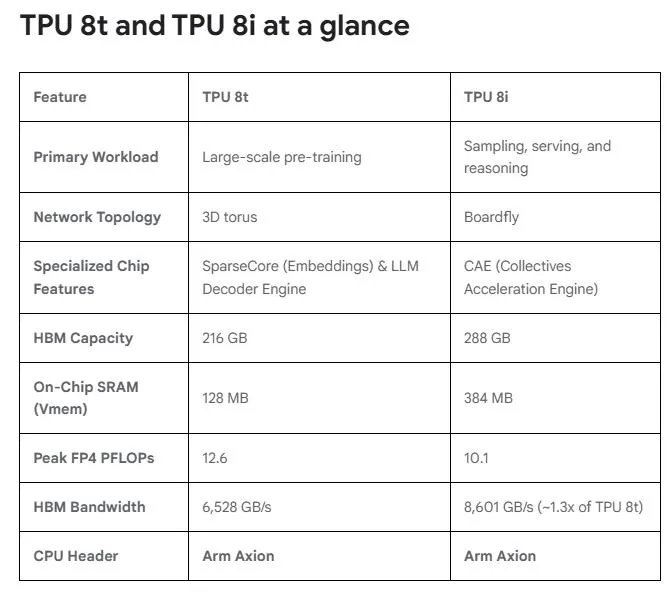
Outro diferencial importante é a adoção da rede de comunicação Boardfly, desenvolvida para a TPU 8i. Segundo o Google, essa combinação permite reduzir a latência em até duas vezes na comparação com a TPU 8t, praticamente sem penalidade de desempenho em razão dos recursos adicionais de segurança.
A arquitetura também permite executar diferentes etapas do desenvolvimento de modelos no mesmo sistema, incluindo ajuste fino com dados privados, destilação de modelos maiores e treinamento de agentes por aprendizado por reforço.
TPU 8i Max reúne dois chips para superar limitações de memória
Enquanto a TPU 8tx prioriza segurança e processamento confidencial, a TPU 8i Max foi desenvolvida para enfrentar outro problema importante da inteligência artificial: a limitação de largura de banda e capacidade de memória.
Modelos modernos podem trabalhar com contextos extremamente extensos, chegando a milhões de tokens. Quando vários agentes de inteligência artificial executam tarefas simultaneamente, a quantidade de informações que precisa permanecer disponível para processamento cresce consideravelmente.
Para enfrentar esse cenário, o Google decidiu combinar dois chips TPU 8i em um único pacote. A configuração oferece o dobro da capacidade computacional, o dobro da SRAM e duas vezes a largura de banda de memória HBM em comparação com uma TPU 8i convencional.
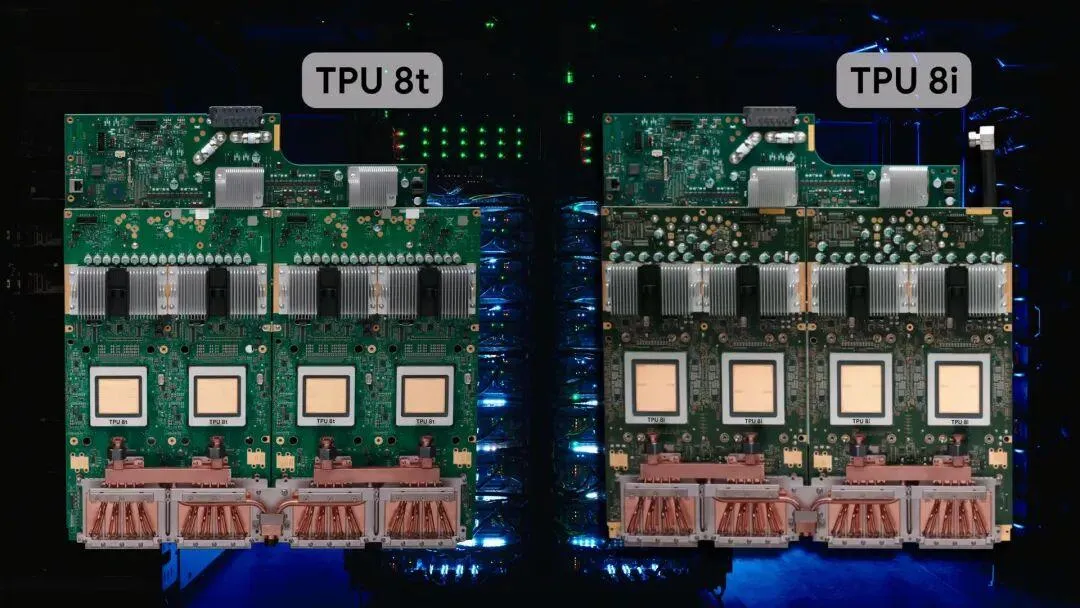
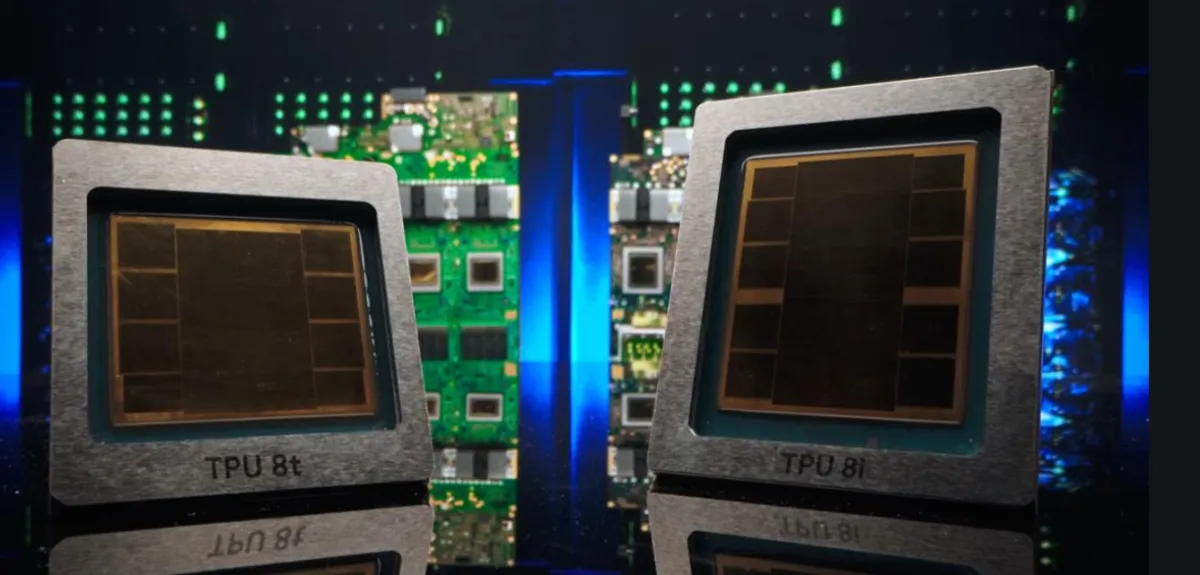
Um dos números mais interessantes é a capacidade de SRAM integrada, que chega a 768 MB. Essa memória de alta velocidade pode manter informações frequentemente utilizadas pelos processadores próximas às unidades de computação, reduzindo a necessidade de acessar camadas mais distantes do sistema.
O Google também afirma que a nova configuração mantém aproximadamente o mesmo espaço ocupado em rack que a TPU 8i convencional. Na prática, isso permite aumentar significativamente a densidade computacional dos data centers sem exigir uma expansão proporcional do espaço físico.
Memória e processamento são fundamentais para agentes de IA
A estratégia por trás da TPU 8i Max está relacionada ao funcionamento dos chamados agentes autônomos de inteligência artificial.
Diferentemente de sistemas que apenas respondem a uma pergunta, esses agentes podem executar sequências de operações, consultar ferramentas externas, analisar documentos, escrever códigos e manter informações de etapas anteriores.
Esse comportamento aumenta a demanda por memória e comunicação entre os componentes. Mesmo quando um processador possui grande capacidade de cálculo, a falta de dados disponíveis na velocidade necessária pode limitar o desempenho geral.
É nesse ponto que a combinação de dois chips TPU 8i ganha importância. Ao ampliar simultaneamente processamento e largura de banda, o Google procura evitar que o aumento da capacidade computacional seja desperdiçado por limitações no subsistema de memória.
Diferenças entre as novas TPUs do Google
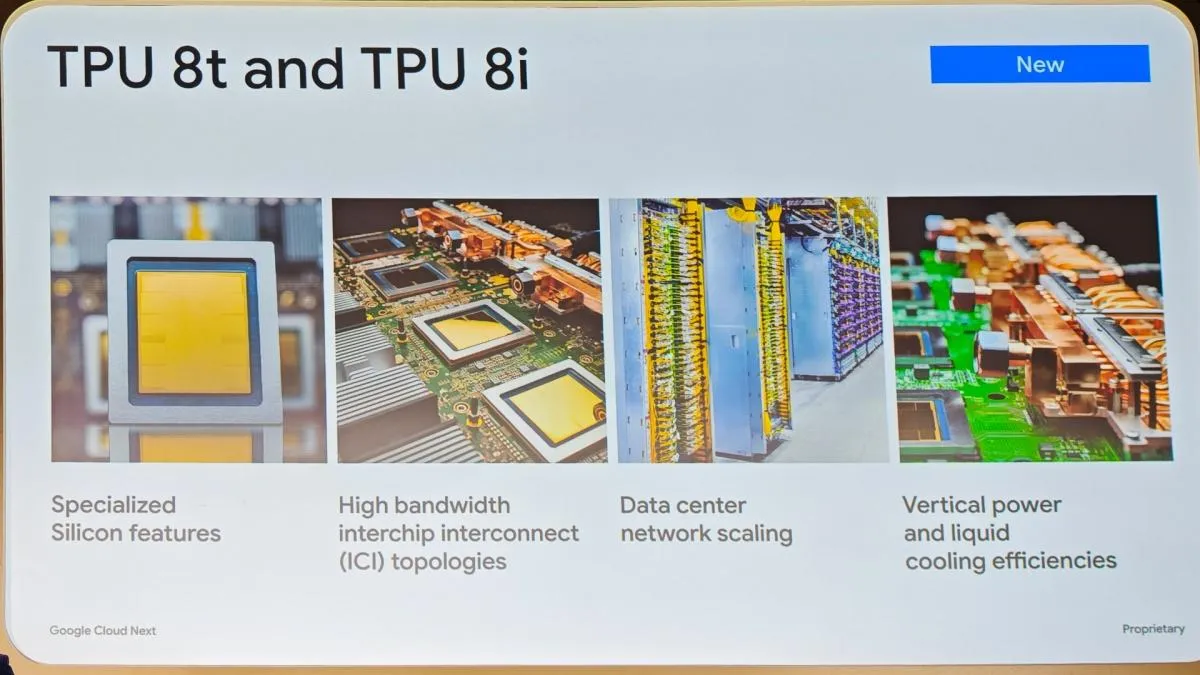
A oitava geração passa a contar com quatro configurações especializadas, cada uma direcionada a uma necessidade específica da infraestrutura de inteligência artificial.
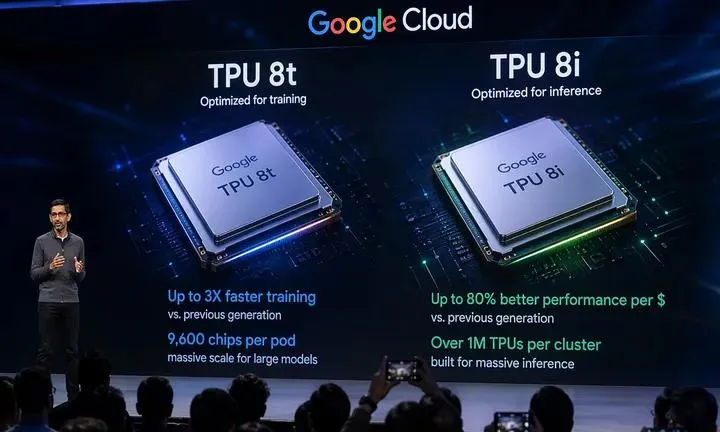
TPU 8t: treinamento de grandes modelos de inteligência artificial.
TPU 8i: inferência e processamento de solicitações com baixa latência.
TPU 8tx: inferência confidencial, segurança de hardware e treinamento de menor escala, com CPUs AMD EPYC de quinta geração.
TPU 8i Max: processamento de grandes contextos, combinando dois chips TPU 8i.
Existe, entretanto, uma informação técnica que ainda precisa ser esclarecida. Embora o Google confirme o dobro da largura de banda HBM na TPU 8i Max, a empresa não divulgou oficialmente a capacidade total de memória HBM disponível nessa configuração.
Também não foram apresentados preços comerciais brasileiros para os novos sistemas.
O que as novidades representam para o mercado de IA?
O anúncio mostra que o Google está investindo não apenas no desenvolvimento de processadores mais rápidos, mas também em configurações especializadas para diferentes necessidades de processamento.
A parceria com a AMD na TPU 8tx demonstra que a empresa está disposta a combinar tecnologias de diferentes fabricantes para desenvolver sua infraestrutura. Já a TPU 8i Max representa uma abordagem diferente, aumentando a quantidade de processamento e memória dentro de um espaço físico semelhante.
Para empresas que desenvolvem modelos generativos, ferramentas de programação automatizada e agentes autônomos, essas mudanças podem representar ganhos importantes de eficiência e capacidade operacional.
Outro ponto relevante é que o Google está ampliando o suporte a tecnologias abertas, incluindo PyTorch, vLLM e SGLang, para facilitar a utilização de suas TPUs por desenvolvedores e empresas.
Conclusão
As novas TPU 8tx e TPU 8i Max mostram como o Google pretende adaptar seus aceleradores às necessidades mais recentes da inteligência artificial. A primeira aposta na proteção de dados durante o processamento, utilizando CPUs AMD EPYC de quinta geração, enquanto a segunda busca eliminar limitações de memória por meio da integração de dois chips em um único pacote.
Embora ainda existam informações técnicas pendentes, especialmente sobre a capacidade total de HBM da TPU 8i Max, as duas configurações ampliam consideravelmente as possibilidades da família TPU v8.
O movimento também reforça a estratégia do Google de competir no mercado de infraestrutura de IA oferecendo soluções próprias, combinando processadores especializados, redes de alta velocidade e tecnologias de memória avançadas.
Fontes
O que achou da notícia?
0 reações
LEIA TAMBÉM


💬 Fórum da Comunidade 0
Ninguém comentou ainda.